

model einer Chat-Completion-Anfrage an.
Diese Seite listet die Modelle auf, erklärt die Registerkarte Modelle in der App und beschreibt, wie die Preise berechnet werden. Die Preise werden automatisch aktualisiert. Die aktuellen Preise finden Sie daher auf der Registerkarte Modelle.
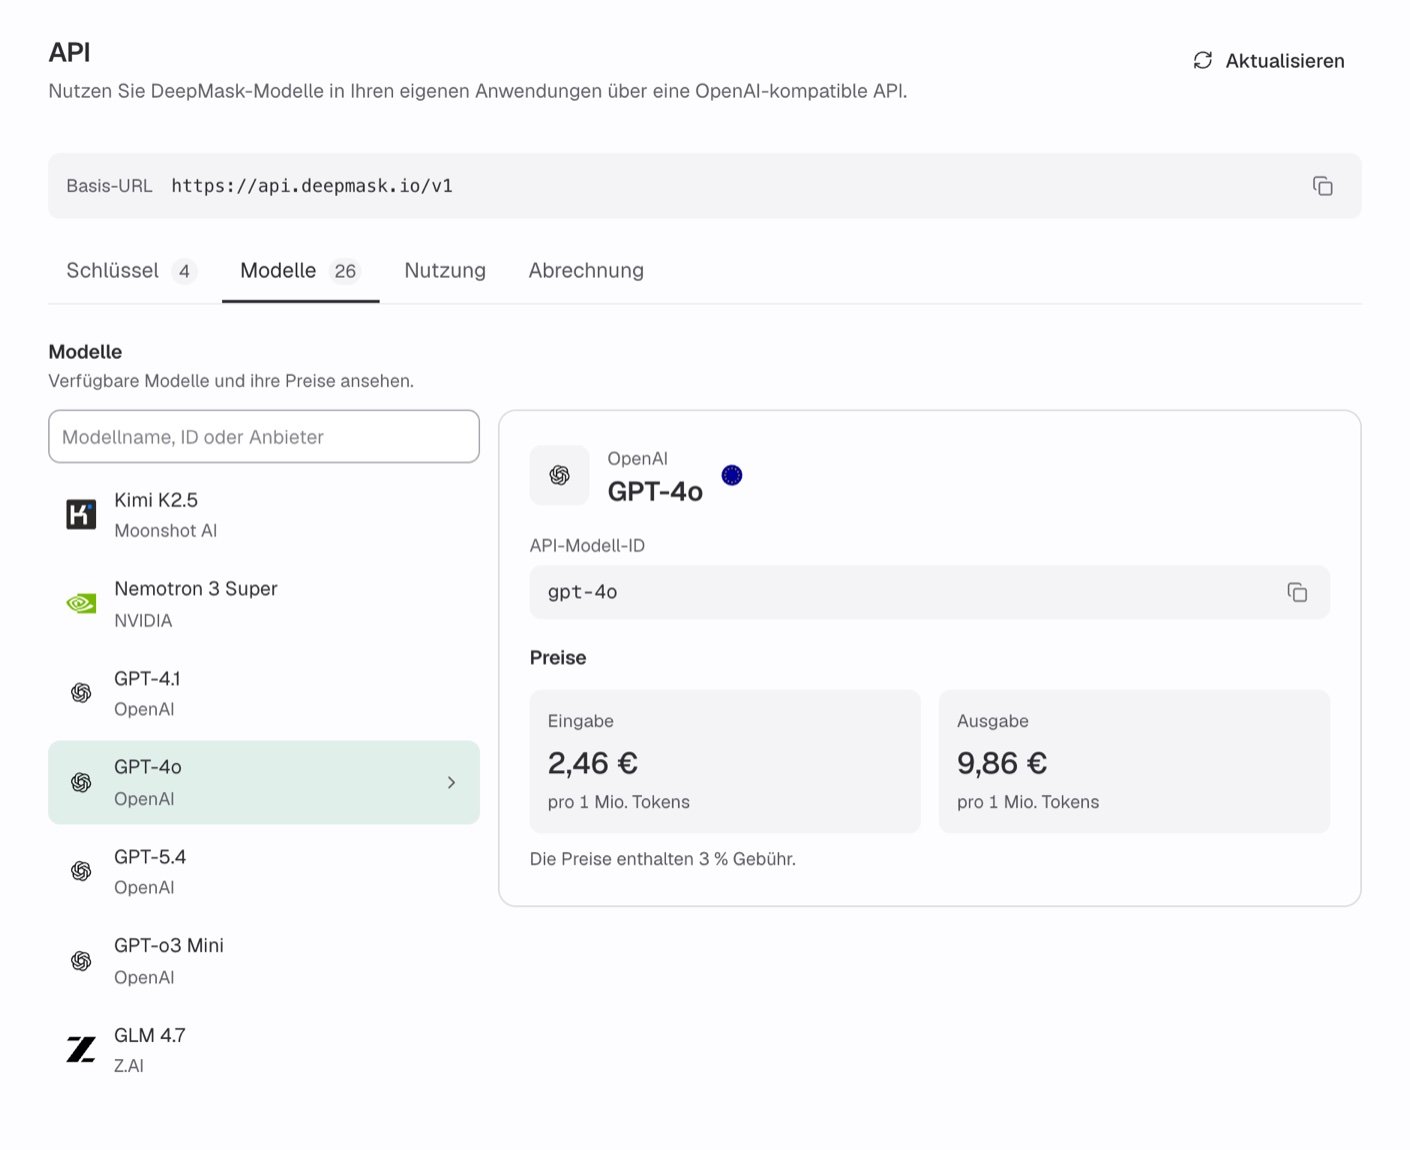
Wählen Sie ein Modell aus, um seine API-Modell-ID und seine Preise pro 1 Mio. Tokens zu sehen.
Modelle in der App ansehen
Klicken Sie unten in der Chat-Seitenleiste auf Ihren Namen und wählen Sie Benutzereinstellungen. Klicken Sie in der Seitenleiste der Einstellungen auf API und wählen Sie dann die Registerkarte Modelle. Nur Administratoren der Organisation können die API-Einstellungen öffnen. Wenn Sie kein Administrator sind, entnehmen Sie die Modell-IDs den Tabellen unter Verfügbare Modelle und fragen Sie einen Administrator nach den aktuellen Preisen. Wer die API nutzen kann, erfahren Sie in der API-Übersicht.- Modellliste: Jeder Eintrag zeigt den Modellnamen und den Anbieter. Die Modelle sind zuerst nach Anbieter und dann nach Namen sortiert.
- Suche: Geben Sie einen Modellnamen, eine ID oder einen Anbieter in das Suchfeld ein, um die Liste zu filtern.
- Modelldetails: Wählen Sie ein Modell aus, um seinen Anbieter, seinen Namen und eine EU-Flagge zu sehen. Wenn Sie den Mauszeiger über die Flagge bewegen, erscheint „Gehostet in der EU“.
- API-Modell-ID: Diesen Wert geben Sie genau so im Feld
modelan. Zum Kopieren klicken Sie auf das Kopiersymbol daneben (Modell-ID kopieren). Die Meldung „Modell-ID kopiert“ bestätigt den Vorgang. - Preise: Die Preise für Eingabe und Ausgabe, jeweils pro 1 Mio. Tokens. Darunter steht der Hinweis „Die Preise enthalten 3 % Gebühr.“
Modelldetails beim Erstellen eines Schlüssels
Wenn Sie beim Erstellen eines Schlüssels die Option Modelle auswählen verwenden, hat jedes Modell eine ⓘ-Schaltfläche. Sie öffnet eine kurze Übersicht mit der Hosting-Region, API-Modi, Kontextfenster, Bildeingabe, Tool-Aufruf und denselben Preisangaben. Bei Bildeingabe steht Unterstützt nur für Modelle, die über die API Bilder akzeptieren. Bei anderen Modellen steht Nicht unterstützt, auch wenn sie in DeepMask Chat Bilder verarbeiten. Den vollständigen Ablauf finden Sie unter API-Schlüssel.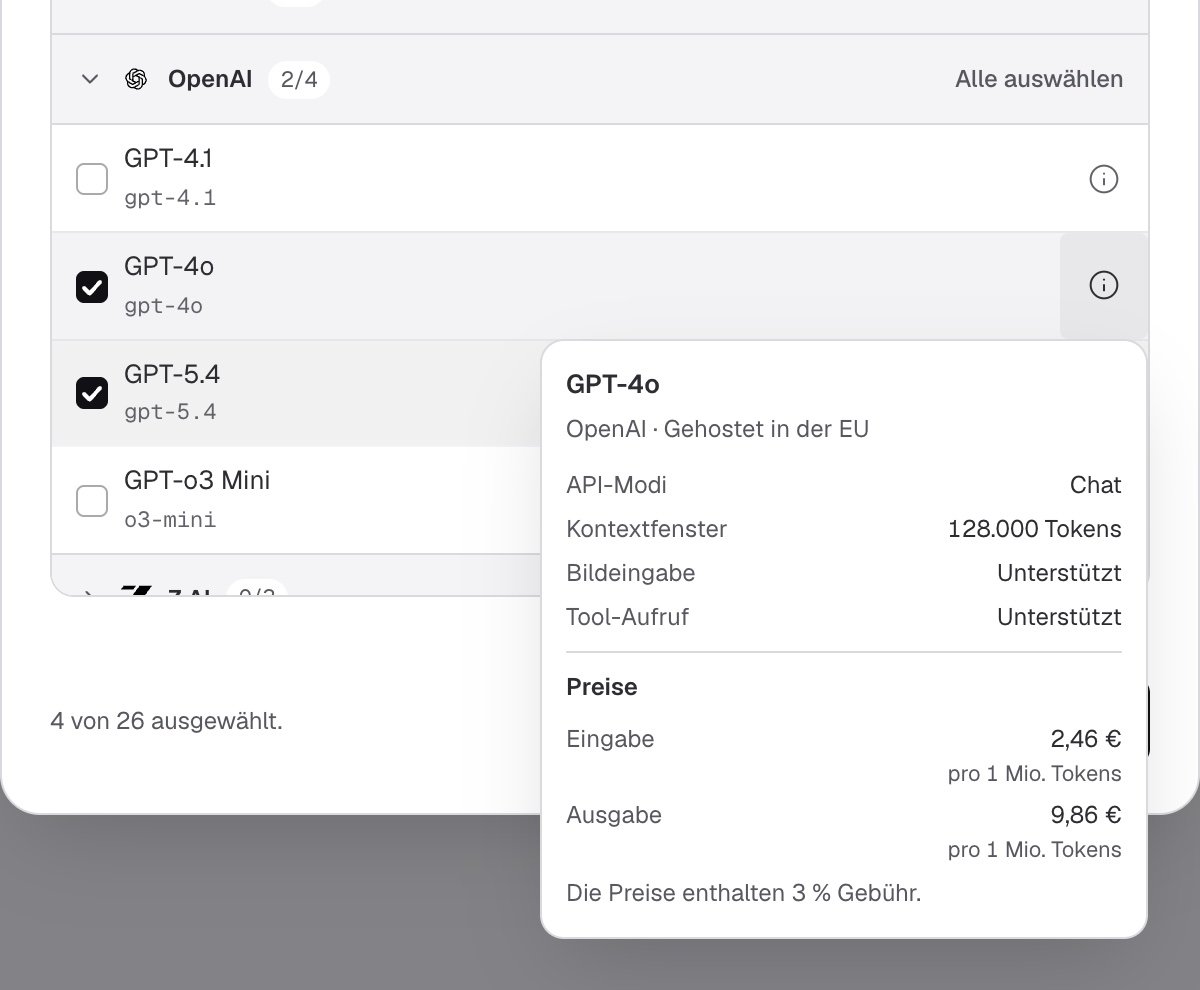
Klicken Sie auf die ⓘ-Schaltfläche eines Modells, um zu sehen, ob es Bildeingabe und Tool-Aufrufe unterstützt und was es kostet.
Verfügbare Modelle
Geben Sie den Wert aus der Spalte API-Modell-ID im Feldmodel an.
- Kontextfenster ist der Wert, der beim Erstellen eines Schlüssels in den ⓘ-Details eines Modells unter Kontextfenster steht. Bei einigen Modellen akzeptiert der Anbieter auch Prompts, die diesen Wert überschreiten.
- Max. Ausgabe-Tokens ist der größte
max_tokens-Wert, den die API für das Modell akzeptiert. Ein größerer Wert wird mit400und dem CodeAPI_REQUEST_UNBOUNDEDabgelehnt.max_completion_tokensist ein Alias mit demselben Limit. Senden Sie aber nicht beide Felder in derselben Anfrage. - Bildeingabe zeigt, ob das Modell Bilder in Benutzernachrichten akzeptiert. Siehe Bildeingabe.
max_tokens-Wert unterhalb des Maximums ablehnen. Eine Ablehnung durch den Anbieter wird nicht abgerechnet.
Wenn Sie max_tokens weglassen, gilt die Standard-Ausgabelänge des Modells. Für glm-4.7 und glm-4.7-flash liegt der Standardwert bei 65.536 Ausgabe-Tokens. Für längere Antworten setzen Sie max_tokens auf einen Wert bis zum angegebenen Maximum.
Wie das Kontextfenster und die Limits für max_tokens funktionieren, erfahren Sie unter Token-Limits.
Manche Modelle ignorieren einzelne Sampling-Optionen wie top_p oder seed, ohne einen Fehler zurückzugeben. haiku-4.5, sonnet-4.5, opus-4.5, opus-4.6 und sonnet-4.6 akzeptieren temperature nur von 0 bis 1. Dasselbe gilt für deepseek-v3.2, glm-4.7, glm-4.7-flash, glm-5, kimi-k2.5, minimax-m2.1, minimax-m2.5, nemotron-3-super und qwen3-235b-2507. Einen höheren Wert lehnt der Anbieter mit API_UPSTREAM_REJECTED ab. Diese Ablehnung wird nicht abgerechnet. Siehe Optionen, die manche Modelle ignorieren.
Anthropic
OpenAI
Weitere Anbieter
deepseek-v3.2 lehnt max_tokens-Werte über 8.000 möglicherweise mit API_UPSTREAM_REJECTED ab. Diese Ablehnung wird nicht abgerechnet.Der API-Katalog unterscheidet sich von den Modellen in DeepMask Chat. Die Chat-Modelle finden Sie unter KI-Modelle.
Bildeingabe
Sieben Modelle akzeptieren Bilder:gpt-4o, gpt-4.1, haiku-4.5, sonnet-4.5, opus-4.5, opus-4.6 und sonnet-4.6. Sie senden jedes Bild als Base64-Data-URL in einer Benutzernachricht. Bildlinks werden abgelehnt und nie heruntergeladen. Andere Modelle lehnen einen gültigen Bild-Part mit 400 und dem Code API_IMAGE_INPUT_UNSUPPORTED ab. Bilder werden als Eingabe-Tokens abgerechnet. Einen separaten Preis für Bilder gibt es nicht.
Wie Sie ein Bild senden, zeigt das Beispiel unter Bild senden. Die Formate und die Limits für jedes Modell finden Sie unter Bilddaten und Bildlimits.
Content-Arrays, die nur Text-Parts enthalten, funktionieren bei allen Modellen. Die Inhaltsregeln für jede Rolle finden Sie unter Nachrichten.
Tool-Aufrufe
Alle Modelle unterstützen Tool-Aufrufe mit Funktionen (Function Calling). Die zulässigentool_choice-Werte und die Unterstützung für parallel_tool_calls unterscheiden sich je nach Modell. Lesen Sie Modellspezifische Einschränkungen für Tools, bevor Sie eines der beiden Felder setzen.
Modelle über die API auflisten
GET /v1/models gibt die Modelle zurück, die der aufrufende Schlüssel verwenden darf. Den vollständigen Katalog liefert der Endpunkt nicht. Die Liste ist nach Modell-ID sortiert. Sie zeigt nicht, welche Modelle Bilder akzeptieren. Diese Angabe finden Sie in den Tabellen unter Verfügbare Modelle.
cURL
- Eine Anfrage für ein Modell, das der Schlüssel nicht verwenden darf, gibt
403mit dem CodeAPI_MODEL_NOT_ALLOWEDzurück. - Ein aus dem Katalog entferntes Modell verschwindet aus der Liste, auch wenn es für den Schlüssel freigegeben wurde.
Neue Modelle und bestehende Schlüssel
Neue Modelle werden bestehenden Schlüsseln nicht hinzugefügt. Das gilt auch für Schlüssel, die mit Alle aktuellen Modelle erstellt wurden. Diese Option trägt den Hinweis „Ohne künftig hinzugefügte Modelle.“ Nach dem Erstellen können Sie die Modelle eines Schlüssels nicht mehr ändern. Um ein neues Modell zu nutzen, erstellen Sie einen neuen Schlüssel, der es enthält. Siehe API-Schlüssel.So funktionieren die Preise
Sie zahlen für die Tokens jeder Anfrage zu den Preisen des jeweiligen Modells. Die Preise sind in Euro pro 1 Mio. Tokens angegeben. Die Registerkarte Modelle zeigt für jedes Modell die aktuellen Preise für Eingabe und Ausgabe.- Die Gebühr ist enthalten: Die Preise auf der Registerkarte Modelle enthalten bereits die Gebühr von 3 %. Die Gebühr wird nicht noch einmal aufgeschlagen. Die Umsatzsteuer ist nicht enthalten. Sie kommt gegebenenfalls auf Ihrer Rechnung hinzu. Siehe Was Sie bezahlen.
- Rundung: Die App rundet die Preise für die Anzeige. Abgerechnet wird mit den exakten Preisen.
- Preisänderungen: DeepMask aktualisiert die API-Preise automatisch. Jede Anfrage wird zu dem Preis abgerechnet, der bei ihrer Ausführung galt. Wenn die Seite schon länger geöffnet ist, klicken Sie auf Aktualisieren, um die neuesten Preise zu sehen.
- Ausgabenlimits: Ausgabenlimits gelten für die Modellkosten vor Gebühren und Steuern. Siehe Ausgabenlimits.
- Ablehnungen durch den Inhaltsfilter werden abgerechnet:
opus-4.7,opus-4.8,opus-5,opus-5.5,sonnet-5,sonnet-5.5undhaiku-5.5können eine Anfrage aufgrund der Sicherheitsklassifikatoren des Anbieters ablehnen. Die Antwort enthältfinish_reason: "content_filter"und wird wie jede andere Antwort abgerechnet.
Preise für lange Prompts
Zwei Modelle berechnen für lange Prompts höhere Preise. Sobald ein Prompt den Schwellenwert überschreitet, wird die gesamte Anfrage zu den höheren Preisen abgerechnet.
Bei
gpt-5.4 ist das Kontextfenster in der App (272.000 Tokens) die Grenze für die Standardpreise. Längere Prompts werden angenommen und zu den Preisen für lange Prompts abgerechnet.
Für diese Modelle zeigt die Registerkarte Modelle die Preise für Eingabe und Ausgabe als Spanne an. Der niedrigere Wert ist der Standardpreis, der höhere der Preis für lange Prompts.
Zwischengespeicherte Eingabe
Die OpenAI-Modelle (gpt-4.1, gpt-4o, gpt-5.4 und o3-mini) speichern Prompts ab 1.024 Tokens automatisch zwischen. Prompt-Tokens aus dem Cache werden zum niedrigeren Preis für zwischengespeicherte Eingabe abgerechnet, nicht zum Preis für Eingabe. Bei gpt-4o und gpt-4.1 können auch Bilder, die Sie erneut senden, etwa im Gesprächsverlauf, aus dem Cache stammen. Sie müssen Ihre Anfragen dafür nicht ändern.
Bei den Anthropic-Modellen, mistral-large-3 sowie den Modellen von Alibaba, DeepSeek, MiniMax, Moonshot AI, NVIDIA und Z.AI gibt es keinen Preis für zwischengespeicherte Eingabe. Jeder Prompt-Token wird zum Preis für Eingabe abgerechnet.
Prompt-Caching von Anthropic ist über die API nicht verfügbar. Ein cache_control-Feld in einem Text-Part wird mit 400 und dem Code API_REQUEST_UNBOUNDED abgelehnt. In einem Bild-Part wird es mit 400 und dem Code API_IMAGE_INVALID abgelehnt. Sie können Inhalte daher nicht für das Caching markieren.
Reasoning- und Thinking-Tokens
Wenn ein Modell vor seiner Antwort nachdenkt (Reasoning), zählen die verborgenen Reasoning-Tokens zumax_tokens und werden als Ausgabe-Tokens abgerechnet. Das betrifft Reasoning-Modelle wie o3-mini und die Claude-Modelle, bei denen Thinking immer aktiv ist: opus-5, opus-5.5, sonnet-5, sonnet-5.5 und haiku-5.5. Bei diesen Claude-Modellen können Sie das Thinking nicht deaktivieren.
Nächste Schritte
Chat Completions
Senden Sie Anfragen an ein Modell, einschließlich Streaming und Tools.
API-Schlüssel
Erstellen Sie Schlüssel und legen Sie fest, welche Modelle jeder Schlüssel nutzen darf.
Limits und faire Nutzung
Sehen Sie sich die Raten-, Token- und Budgetlimits an, die für Ihre Anfragen gelten.
Abrechnung
Aktivieren Sie die API-Abrechnung und rufen Sie Ihre monatlichen Rechnungen ab.